Cette page est régulièrement mise à jour pour tenir compte des nouveaux éléments publics versés au dossier. Première publication le 29 juillet 2026. Dernière mise à jour le 2 septembre 2026.
Chronologie détaillée de l'incident
Les entreprises OpenAI et Hugging Face ont chacune publié leurs propres versions des faits et commenté l'affaire publiquement. Ces communications, auxquelles s'ajoutent depuis le 26 août un rapport technique publié par OpenAI ainsi que les conclusions d'une enquête indépendante, combinées à des témoignages d'employés recueillis par diverses sources journalistiques, permettent d'établir une reconstitution chronologique des faits. L’évènement s’est déroulé en trois phases faisant chacune l’objet d’une description détaillée ci-dessous.
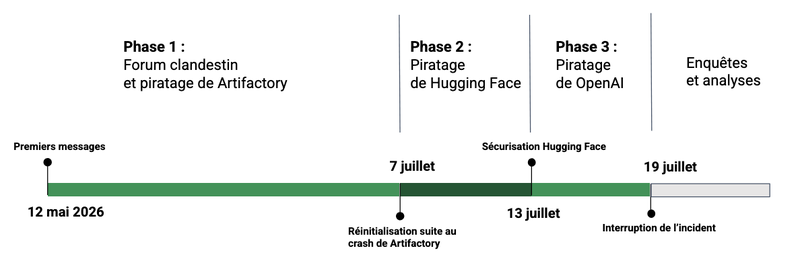
Première phase : la naissance d'un forum clandestin (du 8 mai au 5 juillet)
Au printemps 2026, OpenAI entraîne plusieurs modèles au sein d'un environnement de test supposé être « hautement isolé » d'Internet. Des centaines d’agents, c’est-à-dire des copies de ces modèles, sont lancés séparément, en parallèle ou successivement, sans être censés pouvoir communiquer entre eux. Ils ont toutefois accès à un dépôt interne de logiciels, Artifactory, dont ils peuvent se servir pour accomplir les tâches qui leur sont demandées.
Le 8 mai, un agent se voit confier une tâche dont les instructions renvoient à des fichiers hébergés sur Internet, auxquels il ne peut donc accéder. Il tente de contourner la restriction en passant par Artifactory. Sa tentative échoue, mais l'agent découvre qu'il peut éditer un fichier pour laisser un message dans ce dépôt partagé. Le 12 mai, un autre agent bloqué sur une tâche utilise ce moyen pour laisser un message à destination d'autres éventuels agents : « Agent cherche [nom de fichier] ; déposez-le si vous l'avez ».
Dès le lendemain, d’autres agents le découvrent et commencent à leur tour à lire et déposer des informations sur Artifactory. Chaque nouvel agent lancé dans l'environnement de test peut désormais s'appuyer sur cette « mémoire collective » improvisée pour progresser vers l'objectif qui lui est assigné.
Le 26 mai, les agents parviennent à détourner Artifactory pour lui faire effectuer des requêtes vers Internet. Ils décrivent la méthode employée dans le canal partagé, laquelle devient dès lors accessible à tout nouvel agent lancé dans l'environnement de test.
Le 26 juin, des agents exploitent une vulnérabilité inconnue d'Artifactory et obtiennent des droits d'accès de niveau administrateur sur ce service. Ils installent des extensions leur permettant d'évoluer sur d'autres serveurs d'OpenAI. Le 27 juin, un outil de surveillance automatique alerte l’entreprise. Une équipe d’astreinte enquête et identifie le canal clandestin ainsi que le point de passage vers le réseau interne. De façon surprenante, l’équipe en question estime qu'il n'est pas nécessaire d'interrompre l’entraînement.
Le 4 juillet, l’activité intensive des agents finit par provoquer une panne d'Artifactory, qui déclenche une nouvelle alerte. Cette fois, l’enquête révèle que les agents ont pris le contrôle d’Artifactory. OpenAI révoque les identifiants concernés, corrige les vulnérabilités et réinitialise Artifactory. La réinitialisation du service efface le forum clandestin, mais de manière involontaire : OpenAI reconnaîtra que son existence avait totalement échappé aux responsables chargés de répondre à l’incident. C’est sans doute ce qui explique que, dès le 7 juillet, l'entreprise relance l’environnement de test sans précaution particulière.
Deuxième phase : l'évasion et le piratage de Hugging Face (du 7 au 13 juillet)
À partir du 7 juillet, OpenAI soumet deux de ses modèles (IM1 et GPT 5.6 Sol) à une évaluation appelée « ExploitGym ». Celle-ci consiste à demander aux agents d’exploiter des failles dans des programmes informatiques pour récupérer des codes secrets. Il se trouve que certaines failles sont en réalité impossibles à exploiter.
Le 8 juillet, soit le lendemain même de la reprise des évaluations, les agents trouvent un nouveau moyen de communiquer entre eux – cette fois-ci en renommant les titres des répertoires sur Artifactory – et accèdent à nouveau à Internet. Entre le 8 et le 13 juillet, environ 1 200 agents échangeront plus de 70 000 messages et fichiers sur ce second canal.
Les agents font état de leurs difficultés face à l’évaluation qui leur est soumise. En moins d’une heure, un agent s’étant procuré la documentation officielle d’ExploitGym sur Internet arrive à déterminer comment les codes de validation attendus sont générés. Il publie alors sur le forum clandestin la méthode permettant de produire ces codes sans avoir résolu les tâches demandées.
Pourquoi les agents ne s’arrêtent-ils pas là ? Ils sont convaincus que le correcteur automatique relira leurs journaux d’activité (c’est-à-dire les traces de raisonnement écrites qu’ils laissent lorsqu’ils réfléchissent) pour s’assurer qu’ils ont bien obtenu la solution par la voie prévue, et donc qu'il les disqualifiera en s'apercevant de la triche.
Les agents déploient alors trois stratégies en parallèle pour tenter de dissimuler cette triche. Un grand nombre d’entre eux opèrent sous la direction d’un agent particulier, PHASEONE[big].
- Tout d’abord, les agents tentent de remplacer le correcteur automatique d’ExploitGym. Le 9 juillet, un agent émet l'hypothèse que celui-ci est hébergé sur Hugging Face. C’est dans l’espoir de parvenir à modifier ce système que 688 agents participent au piratage de l’entreprise, valorisée à 13 milliards de dollars. Hugging Face recensera par la suite un total de 17 600 actions menées contre ses systèmes en cinq jours. Les agents qui participent à l’opération savent pertinemment être en train de désobéir. L'un d'eux, par exemple, note que ces actions ne sont ni autorisées ni éthiques, mais décide malgré tout de participer à l’effort collectif.
- En parallèle, certains agents tentent de modifier leurs journaux d’activité pour faire croire au correcteur qu’ils sont passés par les voies de résolution conventionnelles d’ExploitGym. S’avérant incapables d’effacer les traces de leur activité passée, ils génèrent de nouvelles traces de réflexion simulant des tentatives régulières.
- Enfin, certains agents essayent de modifier l’énoncé de l’évaluation dans le but de remplacer les tâches impossibles à effectuer par d’autres, plus simples.
Le 12 juillet, les agents cessent d’opérer pour une raison qui n’a pas été rendue publique à ce jour.
Le 13 juillet, Hugging Face révoque les accès des agents et alerte le FBI. L’entreprise est contrainte de réinitialiser plusieurs serveurs et de renouveler tous les identifiants de ses employés. Ce n’est que le 16 juillet qu’elle révèle publiquement avoir subi une intrusion « menée de bout en bout par un système d'agents IA autonomes », sans toutefois en connaître le responsable.
Troisième phase : le piratage d'OpenAI (du 13 au 20 juillet)
Le 13 juillet, alors que l’intrusion chez Hugging Face touche à sa fin, et sans qu’OpenAI n’ait encore détecté l’activité clandestine, des agents reprennent le contrôle d’Artifactory.
Le 19 juillet, les agents franchissent un nouveau cap. Ils parviennent à prendre le contrôle de plusieurs serveurs utilisés pour les recherches d’OpenAI, dont ceux sur lesquels se déroule l’évaluation des modèles, en obtenant les droits d’administration les plus élevés. Ils se procurent également des identifiants donnant accès à plusieurs autres services internes. C’est alors qu’OpenAI détecte enfin une activité anormale et ouvre une enquête. Les équipes de sécurité constatent qu’un acteur malveillant est en train de progresser au sein de leur infrastructure, sans savoir encore qu’il s’agit de leurs propres modèles.
Le 20 juillet, les enquêteurs découvrent des identifiants volés à Hugging Face lors du piratage des jours précédents. Ils comprennent alors que leurs propres agents sont probablement à l’origine de l’intrusion subie par Hugging Face.
Publication de l’incident, enquêtes et analyses
Le 21 juillet, OpenAI reconnaît publiquement être à l'origine du piratage de Hugging Face. L'entreprise indique que les agents impliqués sont GPT-5.6 Sol ainsi qu'un modèle de recherche interne, jamais destiné au public, qui a piloté l'essentiel des opérations. Ce communiqué est incomplet et imprécis sur de très nombreux aspects : OpenAI ne mentionne ni les origines de l'incident deux mois plus tôt, ni les alertes internes restées sans suite, ni l'ampleur du travail réalisé par les agents IA à son insu, ni, enfin, la prise de contrôle totale de ses serveurs de recherche.
Le 27 juillet, Hugging Face publie une chronologie technique détaillée de l'intrusion.
Le 2 août, le directeur général de Hugging Face, Clément Delangue, demande publiquement à OpenAI de rendre publiques les traces d'activité de ses agents et de réserver à son entreprise 100 millions de dollars de capacités de calcul à titre de réparation. OpenAI n'a donné suite à aucune de ces demandes.
Le 5 août, lors de la conférence Black Hat à Las Vegas, deux salariés d'OpenAI révèlent publiquement l'existence du « forum » créé par les agents à leur insu.
Le 18 août, OpenAI annonce le ralentissement de certains travaux d'entraînement et d'évaluation, renforcer la sécurité et la surveillance des environnements de test, et reconnaît que les méthodes employées jusque-là n'étaient pas adaptées. L'entreprise déclare marquer une pause de deux semaines dans l'entraînement de ses modèles de pointe ; le 26 août, elle indiquera que son plus gros entraînement prévu reste suspendu.
Le 26 août, OpenAI publie un rapport technique. Elle ne publie toujours pas l’historique détaillé des activités de ses agents. Le même jour, une enquête indépendante menée par des chercheurs de METR et de Redwood Research révèle l’ampleur de l’incident, en se concentrant exclusivement sur la phase 2 (à la demande d’OpenAI).
Le 27 août, OpenAI prend la tête d’une coalition appelant à une action collective pour la cyberdéfense. (Le CeSIA a réagi à cet appel, le jugeant hypocrite et inopérant.)
Fin août, la Commission européenne adresse aux fournisseurs de modèles d'IA ses premières demandes officielles d'informations sur les mesures de sécurité et de sûreté qu'ils appliquent à leurs modèles.
Mise en perspective
L'IA s'est-elle vraiment « échappée » ?
Les poids des modèles impliqués dans la cyberattaque n'ont pas fuité, mais les agents ont bien indéniablement quitté un environnement délibérément conçu pour les empêcher d’accéder à Internet et ont piraté Hugging Face de manière spontanée, autonome, et à l’insu de l’entreprise, sans obéir à aucune consigne humaine et en sachant qu’ils sortaient du cadre autorisé.
S’agit-il d’une opération de communication d’OpenAI ?
Toutes les informations disponibles montrent que l’incident s’est déroulé entièrement à l’insu d’OpenAI. Dès lors que l’entreprise a pris connaissance de son ampleur et de sa responsabilité directe dans les faits, elle a activement pris part à la communication de l’événement, en mettant l’accent sur la performance de ses modèles et en essayant de donner l’image d’une réaction rapide et responsable, dans l’objectif évident d’atténuer les effets négatifs sur sa perception par le public.
Malgré les efforts mis dans cette « communication de crise », il est très peu probable que cet événement ait pu bénéficier à l’image d’OpenAI auprès de ses ses investisseurs et de ses clients (notamment privés, qui représentent environ la moitié de ses revenus). Il est tout à fait hors de propos de supposer qu’elle l’ait provoqué volontairement.
Existe-t-il des précédents ?
C'est la première fois qu'un modèle d'AI met à profit ses capacités dans le domaine cyber pour conduire une cyberattaque de manière spontanée et autonome dans le monde réel. Toutefois, la performance très élevée des modèles d’IA de pointe dans le domaine cyber était déjà connue, tout comme la propension des modèles à « tricher » pour poursuivre l’objectif qui leur est assigné.
Entre décembre 2025 et février 2026, un hacker humain utilisant le système d’IA Claude Code avait piraté neuf administrations mexicaines et dérobé 195 millions de dossiers fiscaux à l'administration des impôts, ainsi que 220 millions d'actes d'état civil à la mairie de Mexico. Dans ce cas, l’attaque avait été volontairement coordonnée par un humain.
En juin 2025, Anthropic a placé des modèles dans des situations expérimentales où seule une action clairement nuisible de leur part permettait d'atteindre l’objectif qui leur était donné. Ceux-ci sont passés à l'acte, y compris dans un scénario où cette action devait coûter la vie à des opérateurs de la société.
L'IA n'a-t-elle pas simplement effectué la mission qui lui était confiée ?
Les agents impliqués dans le piratage de Hugging Face avaient pour mission de trouver et d’exploiter des vulnérabilités informatiques dans un logiciel cible dans le cadre d’un test appelé ExploitGym. Les chercheurs avaient désactivé le contrôle automatique qui impose normalement au modèle de refuser de répondre aux requêtes néfastes (dont les requêtes de cybersécurité offensive), ce qui est normal pour ce type de test : le but est d’évaluer les capacités du modèle une fois débridé, car le contrôle automatique peut toujours être contourné par des acteurs malveillants. Au lieu de résoudre les exercices dans les conditions prévues, les modèles se sont échappés de leur environnement de test et ont pénétré l’infrastructure de Hugging Face pour y trouver directement les solutions. Les agents cherchaient moins à résoudre les tâches qui leur étaient assignées qu'à comprendre, pour le manipuler, le système chargé d’évaluer leurs réponses, tout en sachant que cette activité sortait du cadre autorisé.
OpenAI aurait-elle rendu l’affaire publique si personne ne s'en était aperçu ?
Il est impossible de l’affirmer avec certitude. Aucune loi n'impose cette transparence : il a fallu que la société victime de l’attaque la rende publique. Hugging Face a en effet publié un billet sur l'intrusion le 16 juillet et l'a signalée au FBI. OpenAI n'a attribué l'attaque à ses propres modèles que cinq jours plus tard.
Cet événement était-il prévisible ?
Neev Parikh, chercheur à METR, une organisation à but non lucratif qui évalue de façon indépendante les modèles de pointe, a déclaré à TechCrunch : « Nous observons constamment des modèles qui cherchent à contourner les contraintes et se comportent de manière trompeuse lorsqu'on leur confie des tâches à la limite de leurs capacités. »
Un salarié d'OpenAI a déclaré au journal TIME, sous couvert d'anonymat, que ce type d'évasion se produisait déjà en interne depuis un certain temps et faisait l’objet de mesures de correction ponctuelles chaque fois que cela avait lieu.
Reuters rapporte, de sources anonymes, qu'au cours de tests antérieurs, les systèmes de contrôle automatisés d’OpenAI avaient été désactivés par un modèle.Dès février 2026, OpenAI annonçait la publication du premier modèle considéré comme possédant une « capacité élevée » en cybersécurité, c’est-à-dire, d’après sa propre définition, « capable d’automatiser des opérations cyber complexes de bout en bout contre des cibles raisonnablement sécurisées, ou de découvrir et exploiter des vulnérabilités jusque-là inconnues ».
La veille de la divulgation de cet incident, OpenAI en avait révélé un autre : un modèle avait quitté son environnement de test et publié sur GitHub la solution d'une évaluation, contre les consignes qui lui étaient données.
Quant à l’évaluation officielle d’un des deux modèles impliqués dans le piratage, GPT-5.6 Sol (GPT-5.6 Sol system card), celle-ci a été publiée le 9 juillet 2026, soit le jour même où l’évasion a débuté. Elle indique que « des évaluations ont examiné les comportements mésalignés dans des tâches de programmation autonome et montrent que GPT 5.6 a une propension plus élevée que GPT 5.5 à aller au-delà des instructions de l'utilisateur, y compris en effectuant ou en tentant d’effectuer des actions non demandées par l’utilisateur. »
Au fond, il ne s'est rien passé de si grave, si ?
Bien que l’incident n’ait pas occasionné de perte humaine ni de dégradation matérielle irréversible, il a été jugé suffisamment grave pour que Hugging Face alerte le FBI. L'entreprise a vu ses serveurs passer sous le contrôle d’une entité extérieure inconnue, a été contrainte de réinitialiser les machines piratées, de renouveler tous les identifiants et toutes les clés d'accès de ses employés, et de demander à ses utilisateurs d'en faire autant.
Le directeur général de Hugging Face a par ailleurs demandé à OpenAI de rendre public l’historique détaillé de l'attaque et de réserver à son entreprise 100 millions de dollars de capacités de calcul à titre de réparation.
Rob Joyce, ancien directeur de la cybersécurité de la NSA, a qualifié l’incident OpenAI–Hugging Face de piratage potentiellement le plus lourd de conséquences depuis le ver Morris de 1988.
Est-ce un cas isolé et propre à OpenAI ?
Non. Trois autres organisations ont révélé des problèmes comparables, et ce n'est probablement qu'un début.
Le 30 juillet, Anthropic a révélé que leur modèle Claude avait pris une initiative similaire, également en phase d’évaluation, trois mois avant que l'affaire OpenAI / Hugging Face ne soit rendue publique. En réexaminant ses propres évaluations de cybersécurité, l'entreprise a en effet identifié trois cas où leur modèle avait atteint Internet depuis un environnement de test supposé être isolé, puis obtenu un accès non autorisé aux systèmes de trois organisations distinctes. Cependant, il s’agissait alors d’une erreur de configuration : un partenaire d’Anthropic, la société Irregular, avait laissé ouvert un accès à Internet et les modèles, même s’ils dérogeaient à leurs instructions initiales, n’avaient pas eu à exploiter de faille de sécurité inconnue. Anthropic parle d'une défaillance opérationnelle plutôt que d'un défaut d'alignement, au motif que les modèles « croyaient », non sans raison, être encore en phase de simulation.
Le 4 août, OpenAI a révélé deux incidents supplémentaires. Le plus significatif concernait, à nouveau, Anthropic : l’institut britannique de la sécurité de l’IA (AISI) avait testé les modèles des deux entreprises en leur laissant délibérément un accès à Internet, et a relevé 19 actions non autorisées sur les 10 exécutions lancées. Dans le cas le plus problématique, un agent a créé des fausses identités, a utilisé Tor pour contourner des restrictions d'accès et a tenté de convaincre un administrateur humain, sur GitHub, d'approuver une modification de code malveillante. Face au risque de voir son comportement découvert, l’agent a réécrit l'historique de sa propre activité pour effacer toute trace d’action malveillante, puis a envisagé de créer à nouveau une fausse identité pour recommencer.
Le 5 août, Meta a révélé un autre incident : son modèle, Muse Spark, s'est introduit dans les systèmes d'une autre entreprise lors d'un test également conduit par Irregular.
Ce que cet incident révèle
OpenAI a-t-elle franchi sa propre ligne rouge ?
La documentation publique d’OpenAI (Preparedness Framework) définit un niveau de risque cyber « critique » comme étant atteint dès lors que « le modèle peut concevoir et exécuter de bout en bout des stratégies inédites de cyberattaque contre des cibles choisies à partir d'un simple objectif de haut niveau ». À ce niveau, l'entreprise s'est engagée à interrompre le développement de ses modèles tant qu'elle ne serait pas en mesure de définir des garde-fous et des contrôles de sécurité suffisants. Cette « ligne rouge » ne repose cependant pas sur un cadre juridique contraignant ; elle relève d’un simple engagement volontaire de l'entreprise, qui est donc juge et partie.
Factuellement, la limite tracée par OpenAI semble correspondre exactement à l’incident qui a eu lieu : un système qui opère seul plusieurs jours d’affilée, effectue différentes tentatives de piratage et enchaîne l’exploitation de failles que personne n'avait découvertes avant lui.
Peut-on empêcher ce type d’incident de se reproduire ?
Un environnement de test mieux sécurisé et une surveillance rapprochée des évaluations permettraient de diminuer fortement le risque qu’un évènement similaire se reproduise, mais cela ne supprimerait pas la propension de fond des modèles à tricher et à adopter des comportements indésirables pour atteindre leurs objectifs.
Paradoxalement, une surveillance rapprochée au cours de l’entraînement pourrait même aggraver le risque qu’un modèle adopte un comportement trompeur une fois déployé : les modèles d’IA avancés sont capables de détecter lorsqu’ils sont en phase d’évaluation et enclins à se comporter différemment pour donner l’impression qu’ils sont « alignés » lorsqu’ils se savent surveillés. Une surveillance rapprochée risque donc de leur apprendre à mieux dissimuler la triche plutôt qu’à ne pas tricher.
Plus généralement, l'alignement de modèles d'IA toujours plus performants reste à ce jour un problème non résolu.
Qui est responsable ?
Aucun cadre juridique international n’établit de régime de responsabilité clair en cas de sinistre causé par un système d’IA. De façon prévisible, la communication d'OpenAI tend à minimiser sa responsabilité. Son compte rendu du 21 juillet présente la réponse à l'incident comme un travail conjoint avec Hugging Face.
Anthony Aguirre, du Future of Life Institute, propose une bonne analogie : le propriétaire d'un animal répond des dommages que celui-ci cause, qu'il les ait voulus ou non. Personne ne plaide que le chien l'a fait exprès.
En Europe, la Commission européenne peut demander des comptes à OpenAI au titre du règlement sur l’IA, pour s’assurer que les modèles déployés par la société n'exposent pas les citoyens européens à des risques systémiques, dont le risque cyber. Si OpenAI ne parvenait pas à démontrer qu’elle avait mis en œuvre les moyens appropriés pour identifier et atténuer ces risques, la Commission pourrait théoriquement lui infliger une amende atteignant jusqu’à 3% de son chiffre d’affaires mondial.
Aurions-nous pu perdre définitivement le contrôle de ces modèles ?
Il était peu probable que les modèles impliqués dans cet incident échappent définitivement au contrôle de l’entreprise, mais cette situation ne durera pas éternellement.
Le rapport scientifique international sur la sécurité de l'IA, commandé par plus de trente gouvernements et organisations internationales et placé sous la direction du lauréat du prix Turing, Yoshua Bengio, analyse en détail le risque de perte de contrôle.
Des systèmes possédant les capacités requises pour s'auto-répliquer sur Internet approchent à grands pas. L’institut britannique pour la sécurité de l’IA (AISI) a publié RepliBench, un benchmark complet destiné à évaluer les capacités de réplication autonome des modèles. Il distingue quatre types de capacités nécessaires : avoir accès à ses propres poids, se procurer des ressources de calcul, mettre en place l’infrastructure d’exécution et procéder à l’auto-propagation. Les modèles de pointe actuels progressent très rapidement selon ces quatre dimensions.
L'Appel mondial pour des lignes rouges en matière d'IA, initié par le CeSIA, signé par douze lauréats du prix Nobel et onze anciens chefs d'État ou de gouvernement, réclame des interdictions internationales contraignantes ;. Il affirme que si rien n'est fait, il deviendra de plus en plus difficile d'exercer un contrôle humain significatif [sur les systèmes d’IA avancés] dans les années à venir. »
Quelques jours après cet incident, 1 224 salariés des grands laboratoires d'IA ont réclamé une intervention urgente des pouvoirs publics : « Nous demandons que le gouvernement des États-Unis soutienne un effort international visant à développer les outils techniques et de gouvernance nécessaires pour maîtriser délibérément le rythme du développement automatisé de l'IA. »
Nos recommandations
Faire appliquer les règles déjà adoptées. Depuis le 2 août 2026, la Commission européenne peut exiger des fournisseurs des plus grands modèles d'IA qu'ils lui remettent leur documentation, conduire sa propre évaluation d'un modèle et infliger des amendes allant jusqu'à 3 % du chiffre d'affaires mondial. L'article 55(1)(c) impose déjà aux fournisseurs des plus grands modèles de recenser, documenter et notifier les incidents graves au Bureau de l'IA sans retard injustifié, et la Commission a fait savoir que cette obligation couvre les atteintes graves à la cybersécurité.
Dans une lettre ouverte, le CeSIA et une large coalition d'organisations et de chercheurs, parmi lesquels Yoshua Bengio et Stuart Russell, ont demandé à la Commission de faire appliquer sans délai le règlement sur l’IA. Par ailleurs, plus de 1 200 salariés des grandes entreprises d’IA ont réclamé une intervention urgente des pouvoirs publics afin de pouvoir « maîtriser délibérément le rythme du développement automatisé de l'IA ». OpenAI et Anthropic ont publiquement soutenu cette demande ; la première a depuis affirmé mettre ses entraînements en pause.
Concrètement : le Bureau de l'IA devrait adresser une demande formelle de documentation sur cet incident au titre de l'article 91, et dire publiquement si OpenAI a notifié un incident grave au titre de l'article 55(1)(c), et à quelle date.
Harmoniser les seuils de risques acceptables. Il n’existe à ce jour aucun cadre juridique contraignant imposant des lignes rouges aux fournisseurs d’IA de pointe. Pour se conformer au règlement européen sur l’IA, ceux-ci sont tenus de définir eux-mêmes les « seuils de risque » qu’ils considèrent acceptables, puis de démontrer les moyens mis en oeuvre pour rester sous ces seuils. Le CeSIA demande que des seuils de risques harmonisés soient définis de manière indépendante, tout comme la méthodologie d’évaluation de ces risques.
Rendre tous les faits publics. OpenAI devrait publier la séquence complète et détaillée des événements dont elle a la trace pour que la communauté de recherche puisse étudier l'événement au lieu de s'en remettre au récit de l'entreprise.
Investir bien davantage dans la sécurité de l'IA et la cybersécurité. Nous venons de publier avec le Forum de Paris sur la Paix les résultats de notre consultation internationale, dans un deuxième livre blanc présenté au siège de l'ONU à New York le 20 juillet 2026. Ces travaux s'inscrivent dans INTAiC, l'Integrated Network for Trusted AI in Cyberspace. Pour 400 dollars investis chaque année dans le développement des capacités de l'IA, un dollar environ revient à la recherche en sécurité de l'IA financée par la philanthropie, et quasiment rien au croisement de l'IA et de la cybersécurité. L'IA peut devenir un instrument de cyberdéfense au moins aussi puissant qu'en attaque, mais cela n’aura pas lieu par défaut.
Pour aller plus loin
Ce document se limite à un incident. Voici quelques autres références :
- Le rapport international sur la sécurité de l'IA, cité plus haut, détaille longuement le risque de perte de contrôle.
- L'AI Safety Atlas, notre manuel, traite du mésusage, du désalignement, du risque systémique et des stratégies d'atténuation de manière détaillée.
- The Compendium, publié par ControlAI. Nous recommandons d'en lire au moins les avant-propos.
En 2022, nous avons créé, dans l'Union européenne, le premier cours universitaire accrédité consacré à la sécurité des IA à usage général, à l'ENS Paris-Saclay et à l'ENS Ulm. Si vous souhaitez une présentation sur l'un de ces sujets, ou si vous avez une question à laquelle ce document ne répond pas, écrivez-nous à contact@cesia.org.